Восемь методов: проверять действия агента, сохранять состояние и измерять весь рабочий процесс.
26.10–02.11.20268 основных статей3 на радаре
О чём пишут
На этой неделе авторы разбирают ошибки на границах AI-приложений: между согласием и выполнением, серверным снимком и черновиком, потоком модели и интерфейсом. Каждую границу можно проверить отдельно. Сравнения инструментов тоже требуют аккуратности: короткий ответ ещё не означает меньший счёт, а хороший результат на открытых задачах не заменяет отложенную проверку. Ниже собраны методы с конкретными шагами и названными ограничениями.
01
Что попробовать руками
01
Привяжите согласие человека к точной операции агента
Флаг approved теряет смысл, если агент после подтверждения меняет сумму или получателя. Автор разбирает протокол, который связывает согласие с каноническими аргументами и проверяет его перед выполнением.
Главное
Храните предложение операции, запрос согласия и решение человека отдельно; свяжите их через intentHash.
Перед выполнением проверьте срок действия, текущие полномочия и отсутствие consumedAt. В примере блокировка записи и outbox объединены в транзакцию.
Любое изменение канонических аргументов требует нового согласия; более мягкое правило нужно описать в политике.
Готового приложения нет: схему входа, хранилище и проверку политик придётся подключить самостоятельно.
Попробовать за вечер
Возьмите один вызов инструмента без внешнего эффекта и добавьте proposalId, intentHash, expiresAt и consumedAt по схеме статьи.
Напишите проверки изменения суммы после согласия, просроченного разрешения и двух одновременных попыток его использования.
Метрика: изменённые и просроченные операции отклонены, повторное использование разрешения не создаёт второй эффект.
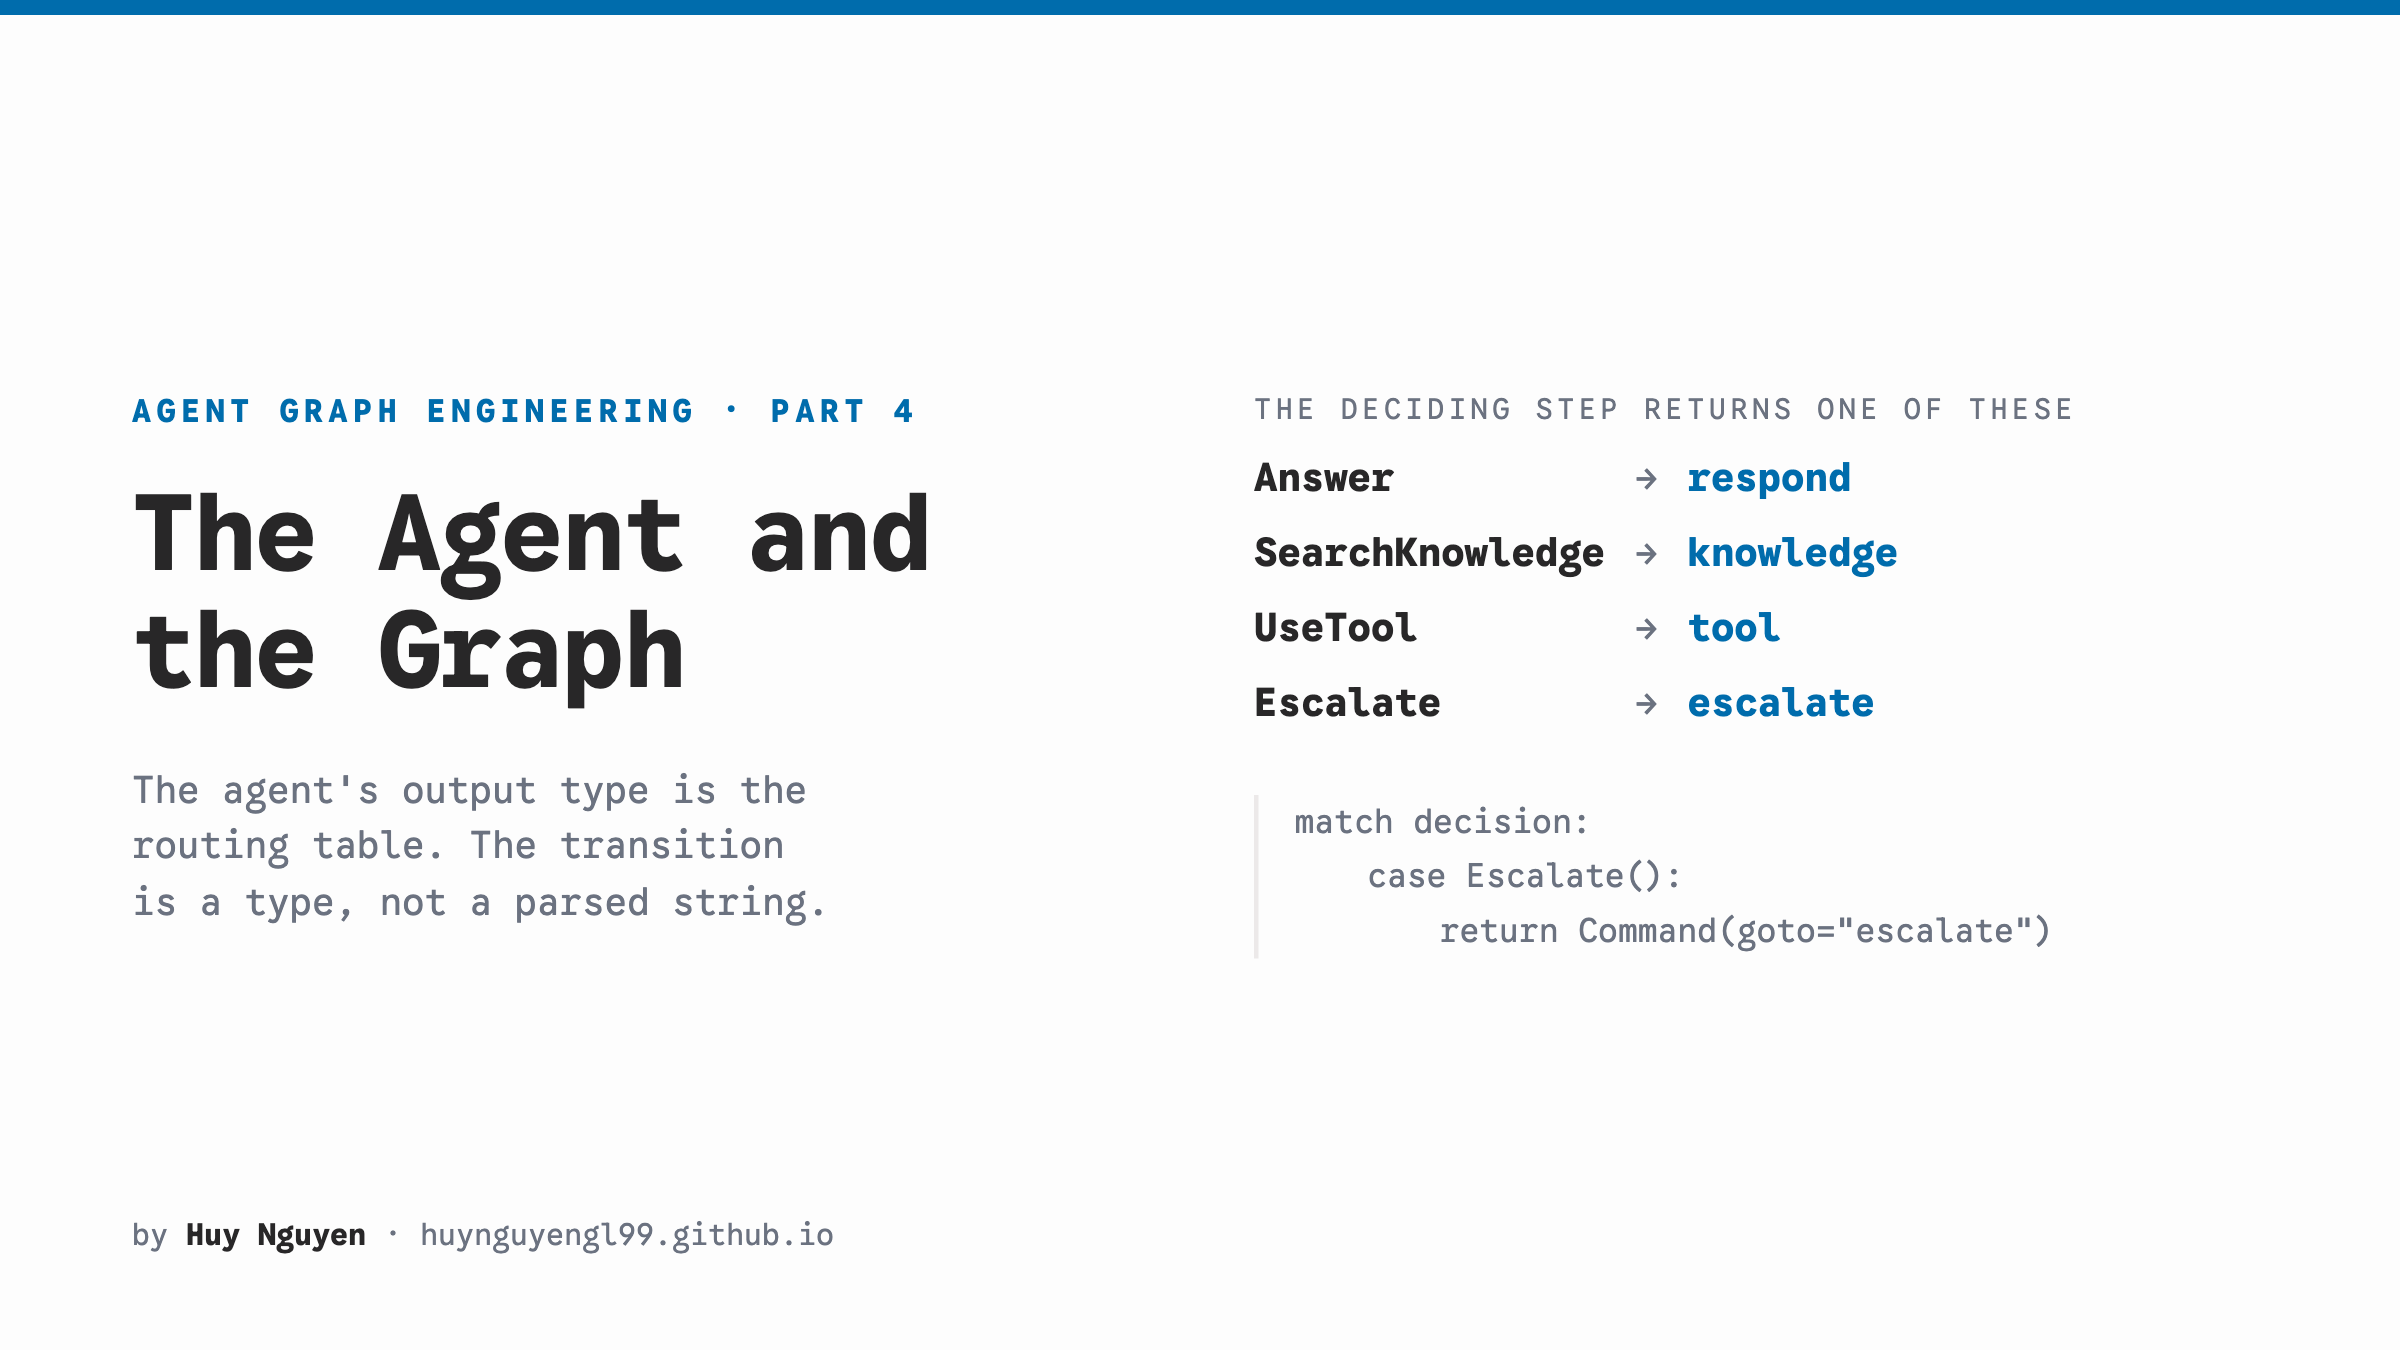
Вместо строки search модель возвращает Pydantic-объект с проверенными полями. Узел выбирает переход по типу объекта, а параметры поиска передаёт через состояние.
Главное
Составьте объединение типов Answer, SearchKnowledgeBase и RunTool; описание каждой ветви одновременно помогает модели выбрать действие.
Отделите функцию маршрутизации _route_for: её можно проверять без модели и запуска графа.
Передавайте в поиск decision.query, который уже сформировал маршрутизатор, вместо повторной обработки всего обращения.
Фрагменты опираются на авторские базовые классы. Аннотации переходов требуют настроенной проверки типов; сами по себе они не гарантируют обработку каждой ветви.
Попробовать за вечер
В небольшом маршрутизаторе замените строковый intent объединением Pydantic-моделей из статьи.
Вынесите выбор узла в отдельную функцию и проверьте каждый тип результата, включая эскалацию для разных аудиторий.
Метрика: у каждого допустимого типа есть проверенный переход, неверная структура ответа отсекается на границе.
Тип результата задаёт маршрут: Answer, SearchKnowledge, UseTool и Escalate.
Автор сравнивает размер ответов для чтения Jira, GitHub и проверки выгрузки CSV. Эксперимент показывает, почему выбор полей и способ проверки результата нужно отделять от выбора интерфейса.
Главное
В пятишаговой браузерной проверке MCP вернул 731 токен текста, CLI — 744; считали через o200k_base.
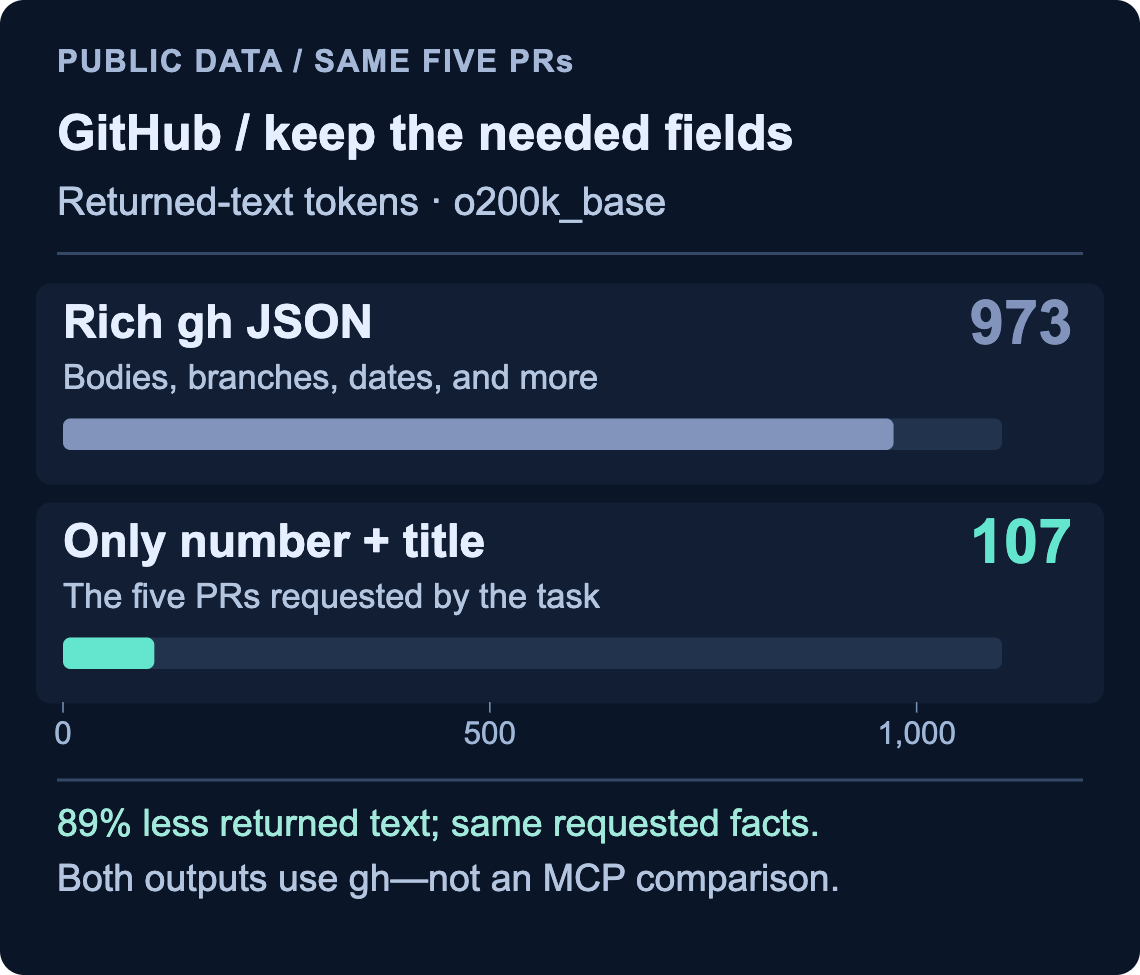
Проекция пяти GitHub PR до номера и заголовка сократила ответ с 973 до 107 токенов. Оба ответа получены через gh.
Проверка состояния страницы и чтение скачанных байтов CSV подтверждают разные вещи; сравнивайте маршруты с одинаковой проверкой.
Это объём возвращаемого текста, без модельного вывода и общего счёта. Jira работает на синтетических данных, вызовы с кодом используют уже запущенный браузер.
Попробовать за вечер
Для одной задачи чтения PR запросите богатый JSON, затем только number,title через gh --json и --jq. Проверьте, что нужные факты сохранились.
Посчитайте токены обоих ответов через tiktoken с o200k_base; отдельно запишите полноту результата и ошибки.
Метрика: число токенов возвращённого текста при сохранении всех фактов, необходимых выбранной задаче.
Один CLI gh: 973 токена для богатого JSON и 107 для номера и заголовка пяти PR. Это размер возвращённого текста, не счёт модели.
Автор сравнил свой линтер с шестью skills и базовым Claude на задачах редактирования файлов. Для рабочего процесса полезнее всего режим сравнения: он замечает потерянные факты после переписывания.
Главное
Команда npx ai-slop-linter --compare before.md after.md проверяет числа, версии, даты, ссылки, цитаты, код и имена.
При найденном расхождении проверка завершается с кодом 1; plugin запускает её после каждой правки.
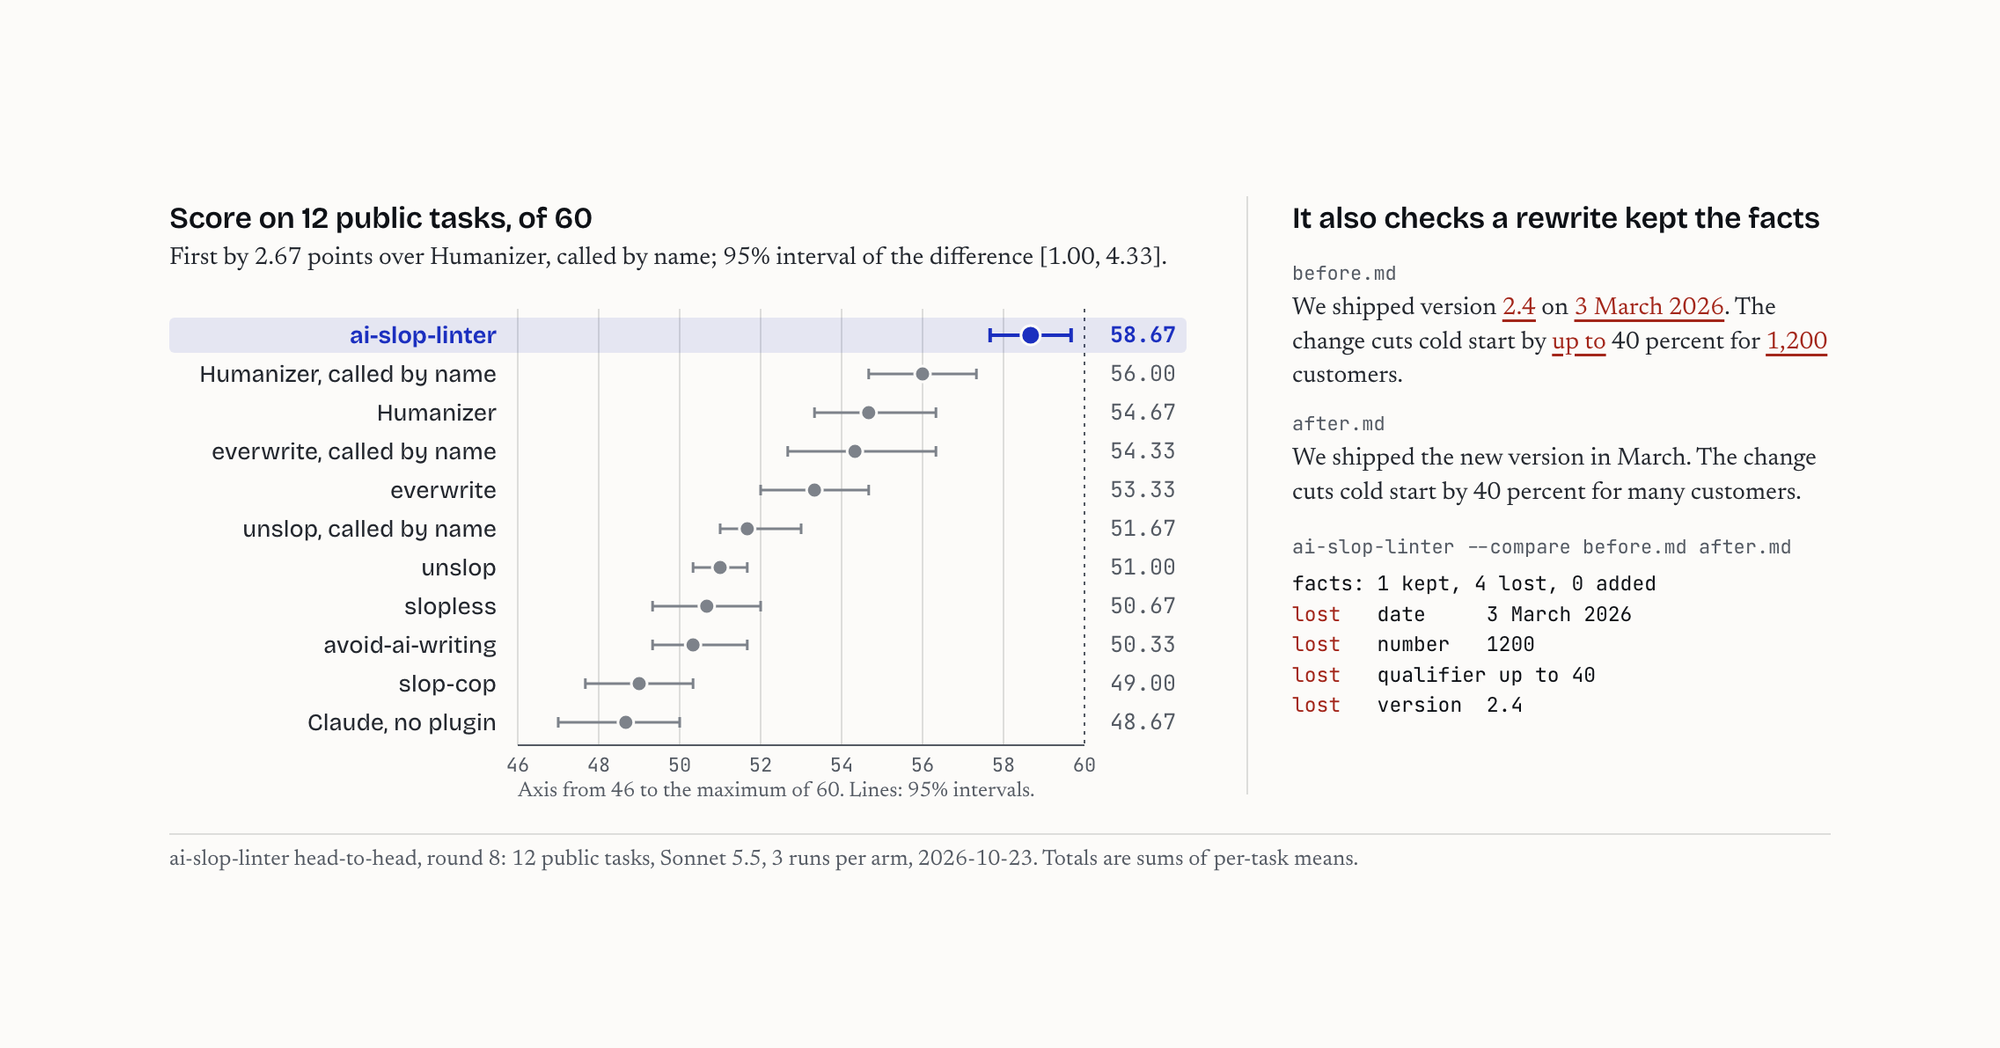
На открытых задачах автор получил 58,67 из 60, но на отложенном наборе четыре варианта набрали не меньше 29,67 из 30.
Ограничение: сравнение фактов не определяет качество текста; результаты не дают общего рейтинга инструментов.
Попробовать за вечер
Сохраните README до правки в before.md и выполните npx ai-slop-linter README.md.
После правки сохраните after.md и запустите npx ai-slop-linter --compare before.md after.md; разберите каждую потерю.
Метрика: число потерянных фактов и время ручной проверки до и после добавления линтера.
Авторский benchmark на 12 открытых задачах и пример потерянных фактов после правки. Отложенный набор не разделяет лидеров.
Для чтения на телефоне: на открытых задачах ai-slop-linter получил 58,67/60; Humanizer с вызовом по имени — 56/60. Пример справа показывает потерю даты, номера версии, числа клиентов и оговорки «до 40%». Это проверка фактов, а не оценка качества прозы.
Прокси сокращал ответы MCP-серверов на 70–94%, но на реальных задачах агент часто запрашивал исходник обратно. Автор показывает, как targeted retrieval, ленивый список инструментов и проверка окружения меняют итог эксперимента.
Главное
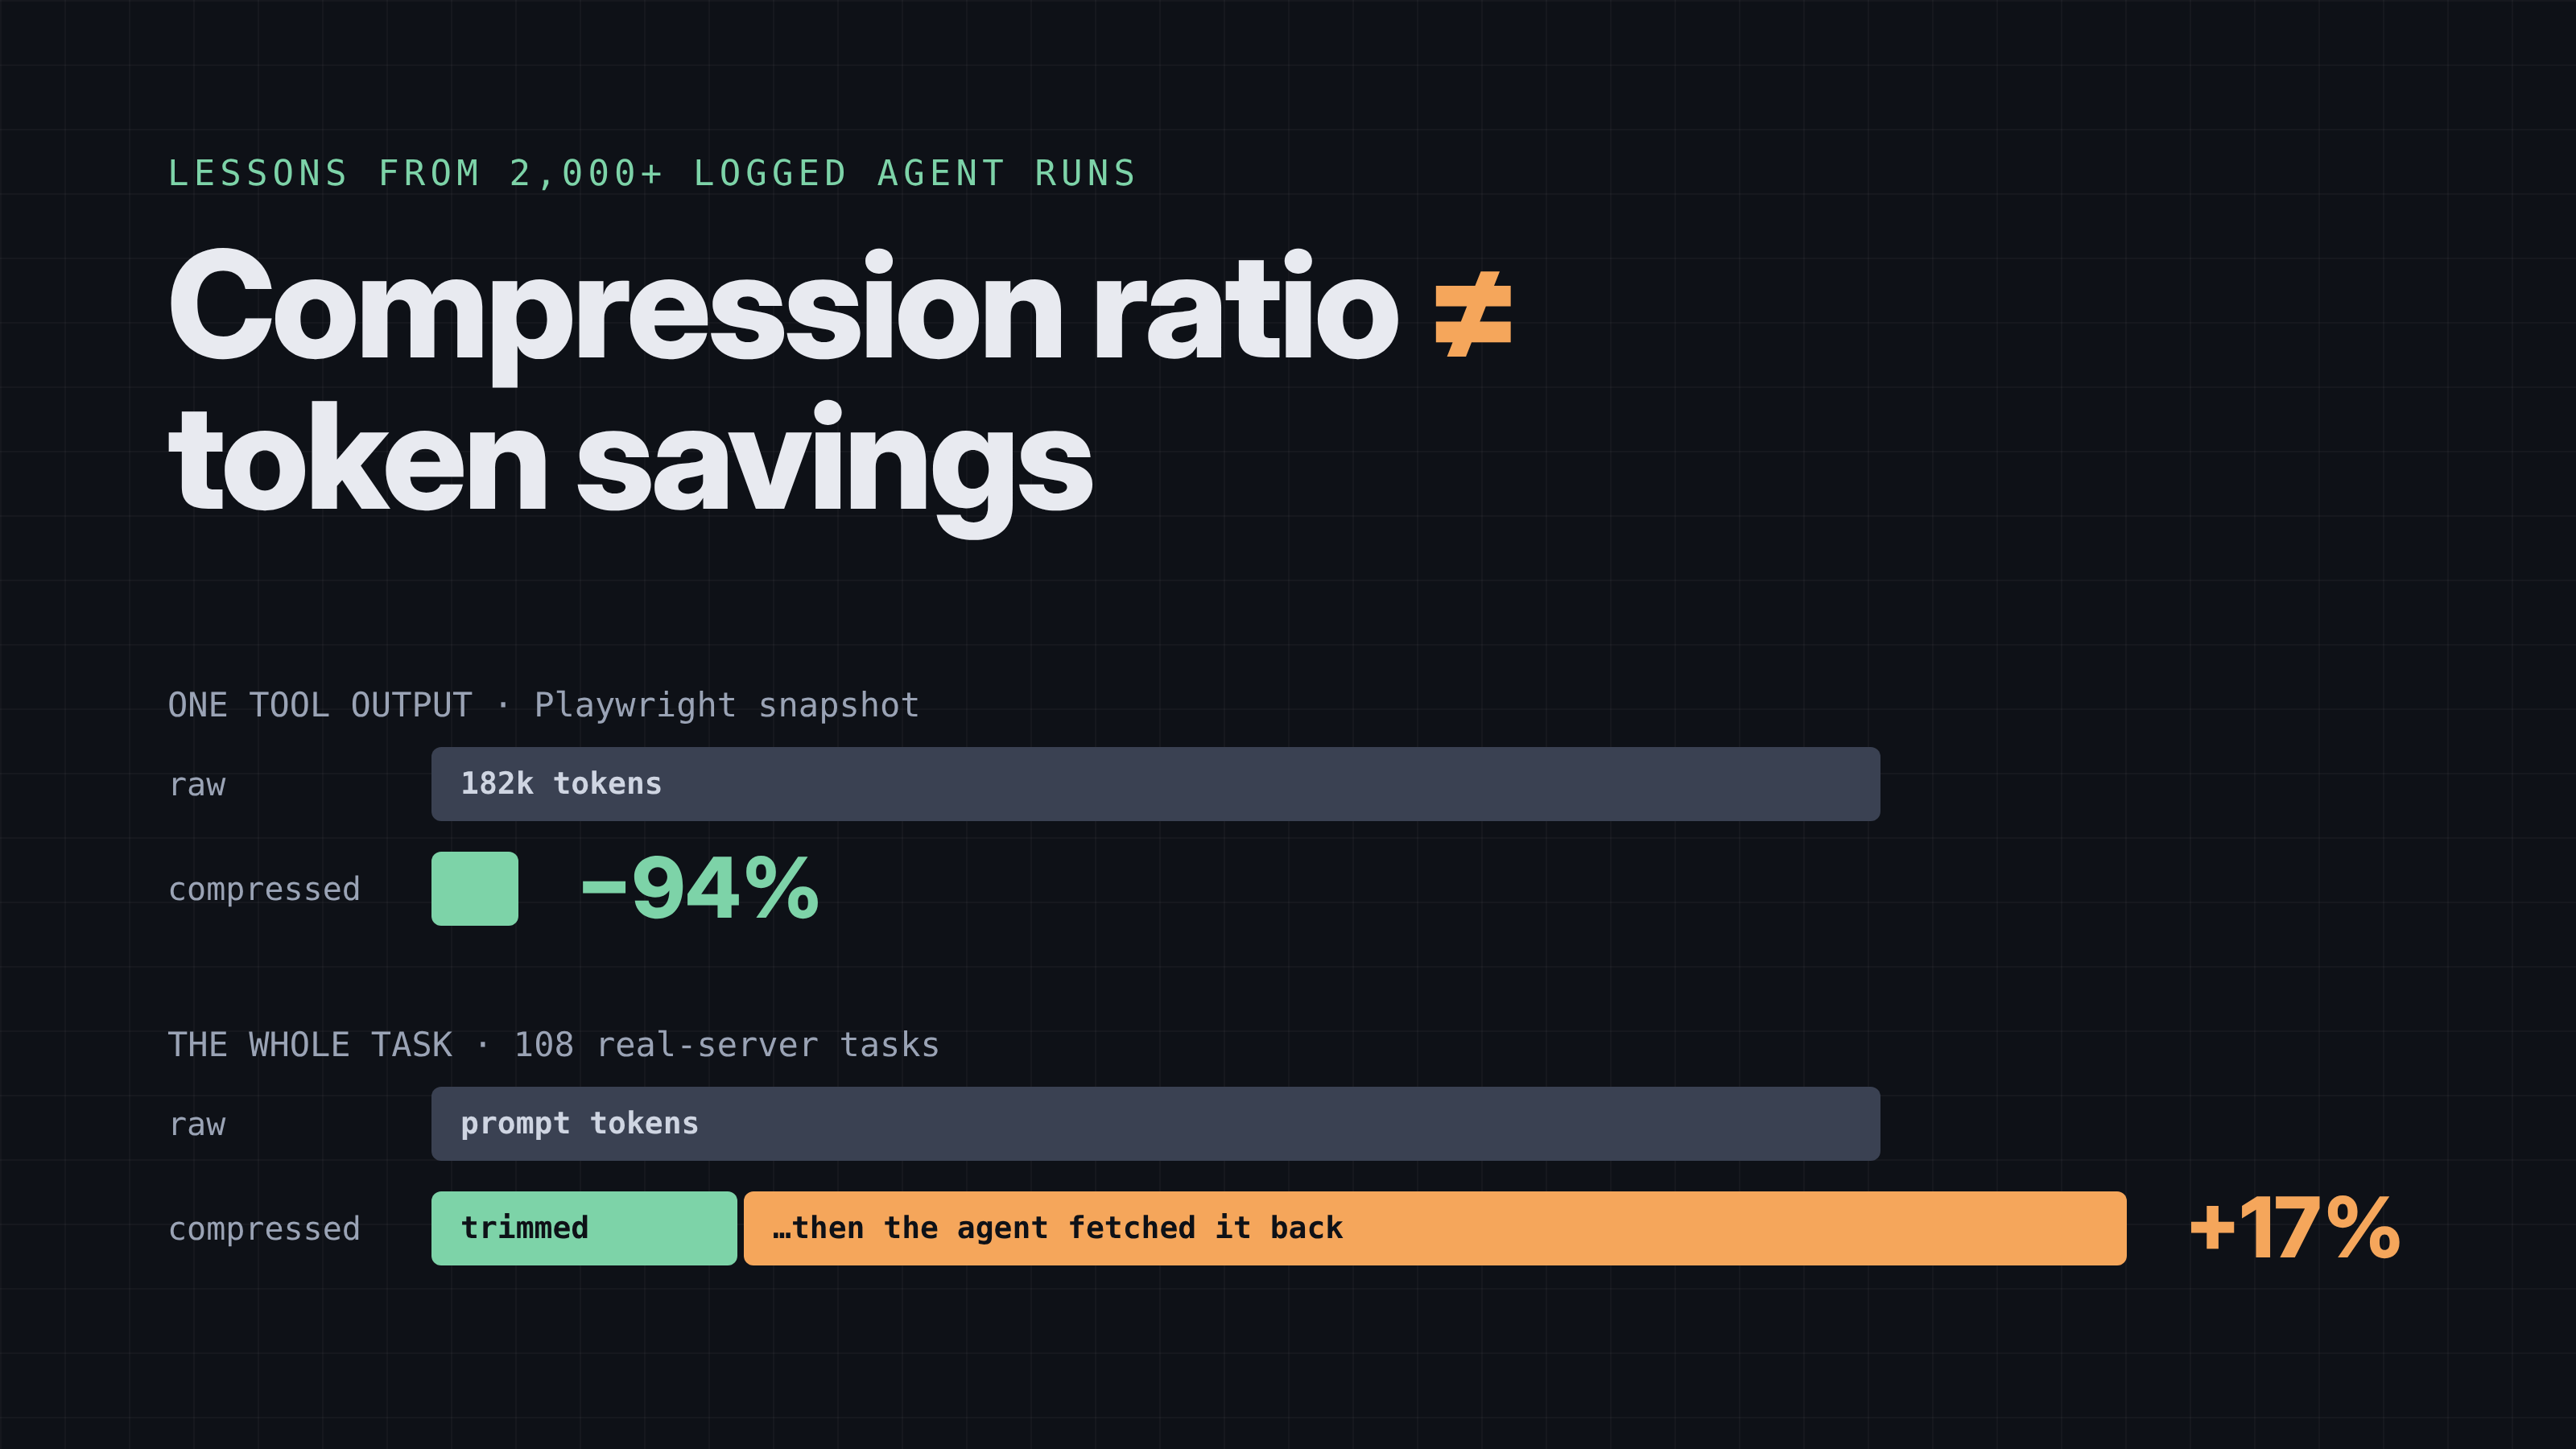
На 108 задачах обычный прокси увеличил prompt tokens на 17%: модель платила и за сжатый ответ, и за восстановленный файл.
Поиск внутри сохранённого ответа вместо полного expand убрал этот перерасход; на 54 real-server dev tasks экономия составила лишь 0,3%.
Инструмент expand стоит объявлять после первого сжатия через notifications/tools/list_changed.
Ограничение: тесты охватывали короткие задачи и преимущественно Qwen3 4B; это не прогноз экономии для больших моделей и длинных сессий.
Попробовать за вечер
На одинаковых задачах сравните raw MCP output и сжатый ответ с восстановлением по search или диапазону строк.
Проверьте передачу нужных env-переменных в дочерний сервер; показывайте expand только после первого сжатия.
Метрика: суммарные prompt tokens на завершённую задачу, доля правильных ответов и случаи потери нужных данных.
Сжатие одного ответа на 94% соседствует с ростом токенов всей задачи на 17% в другом, явно указанном наборе.
В React-редакторе чтение через WebMCP заменяло несохранённое поле данными сервера. Причина оказалась в общем merge-пути: он защищал ввод во время запроса, но терял правки, сделанные раньше.
Главное
Автор воспроизвёл ошибку в Trip Workbench на commit 4b3f370 без запроса сохранения.
Для refresh сравниваются текущие saved base, local buffer и incoming snapshot: локальное отличие от base сохраняется.
Старая revision не должна заменять уже принятую новую; пересечение правок нужно показывать человеку.
Ограничение: локальный вариант прошёл девять coordinator sequences с подставными ответами API; native и model-driven WebMCP ещё не проверены.
Попробовать за вечер
Добавьте тест: измените поле до read-запроса, задержите ответ через deferred promise и убедитесь, что локальный ввод сохранился.
Повторите с ответом revision 1 после подтверждённой revision 2; проверьте буфер, dirty flag и принятую revision.
Метрика: число пройденных сценариев сохранения локального ввода и отсутствие отката revision.
Автор разделяет два сбоя между шагами LLM: сломанный JSON с верным содержимым и корректный JSON с неверным ответом. Небольшая модель помогает в первом случае; во втором нужно повторить исходную задачу.
Главное
До парсинга проверьте stop_reason или finish_reason: усечённый ответ нельзя восстановить расстановкой скобок.
Лестница восстановления: обычный парсер, короткий список безопасных исправлений, затем небольшая модель с узким промптом JSON repair tool.
После исправления снова проверьте схему и смысл: существование ID, полноту разделов и неожиданные пустые списки.
В статье нет готовой реализации проверки сохранности всех ключей и скалярных значений; результат модели-ремонтника остаётся недоверенным.
Попробовать за вечер
Возьмите сохранённые невалидные ответы своего пайплайна и разделите их на усечённые, синтаксически сломанные и семантически неверные.
Прогоните полные ответы через парсер, разрешённые исправления и узкий промпт из статьи; сохраняйте исходник, исправленный JSON и результат повторной валидации.
Метрика: Доля успешно восстановленных ответов без изменения содержания; стоимость и задержка с учётом повторов исходной задачи.
Сбой спиннера, повтор ответа или поздний токен после отмены можно воспроизвести без живой модели. Автор выносит поток в зависимость ChatStream и управляет последовательностью событий из компонентного теста Cypress.
Главное
ChatStream возвращает AsyncIterable; тестовая фабрика позволяет отправлять события по одному через push и завершать поток через close.
Сообщения и карточки инструментов связываются со стабильными ID, чтобы повторные события не создавали дубликаты.
После нажатия Stop тест отправляет ещё один token и проверяет, что текст сообщения не изменился.
Приложение и протокол синтетические: эти тесты не проверяют прокси, сетевую доставку и качество ответов модели.
Попробовать за вечер
Передайте поток в React-компонент через ChatStream и подключите createTestStream из статьи в компонентном тесте.
Проверьте начало потока, постепенный текст и завершение инструмента; отдельным тестом отправьте поздний токен после Stop.
Метрика: Повторяемость тестов в CI и число обнаруженных ошибок отмены, повторных событий и переходов состояния.
Статья предлагает StrictDoc и Tracey для поиска дрейфа спецификации. Связь инструментов показана не полностью; учебный пример JWT нельзя переносить в production без отдельной проверки.
Автор предлагает пересматривать слои retrieval при смене модели. Это повод для собственного контрольного эксперимента, а не правило удалять RAG из любого приложения.
Автор измерил Nemotron на конкретном Xeon и небольшом наборе запросов. Относительные даты лучше разрешать кодом; результаты чистого синтетического аудио не описывают шумный микрофон.
Добавить к mock-tool одноразовое согласие и проверить изменение аргументов после подтверждения.
до среды
Воспроизвести поздний токен после Stop в компонентном тесте интерфейса.
до пятницы
Сравнить два ответа одного инструмента по токенам и сохранности нужных фактов.
до воскресенья
Как собран выпуск
Поисковый индекс HackerNoon вернул всю неделю: 233 статьи. Просмотрены 60 кандидатов, 24 прочитаны целиком. После проверки применимости и попытки опровержения выбраны восемь основных статей; ещё три вынесены на радар. Непрочитанные материалы сохранены в резерве.
Окно26.10–02.11.2026 · 7 дней
Собрано2026-11-02T07:25:12.599122Z
ИсточникПоисковый индекс HackerNoon; вся неделя, полное покрытие
ОтказыНет; тексты доступны у всех 233 статей
Счётчик прочтений209 из 233; в отборе не использовался